— Blog
メモリを足せばVRAMの代わりになるのか? 増設前後で実測し、128GB小型PCの仕組みと自作費用も調べた
目次
- この記事の結論(3行)
- きっかけ:128GBメモリのPCで80GB級のAIが動いた
- 検証に使ったPCとやり方
- 増設前:はみ出した瞬間に遅くなる
- 増設後:変わったのは120bだけ
- なぜ速くならないのか:速さはメモリの「道幅」で決まる
- DAIV CXは、メモリの遅さをハードでどう解決しているか
- 同じものを自分で組んだら、いくらかかるか
- A. 同じチップのミニPCを買う(約58万円)
- B. 同じチップのマザーボードで組む(約61万円)
- C. 一般の部品で帯域を近づける(約87万円)
- D. 普通の自作PCにメモリ128GB(約52万円)
- 許容値で見ると、どれを選ぶべきか
- おまけ:増設後にAIがGPUを使わなくなった話
- まとめ
- 出典・参考
「GPUのメモリ(VRAM)が足りないなら、PCのメモリを足せばいいのでは?」──128GBのメモリを積んだ小型PCで80GB級のAIが動いた、という記事を読んで、そう考えた方も多いと思います。そこで弊社の検証用PCのメモリを32GBから64GBに増設し、増設の前後で同じベンチマークを取りました。あわせて、その小型PCがなぜ速いのかをハードの仕組みから整理し、同じことを自作で実現したらいくらかかるかも見積もりました。
この記事の結論(3行)
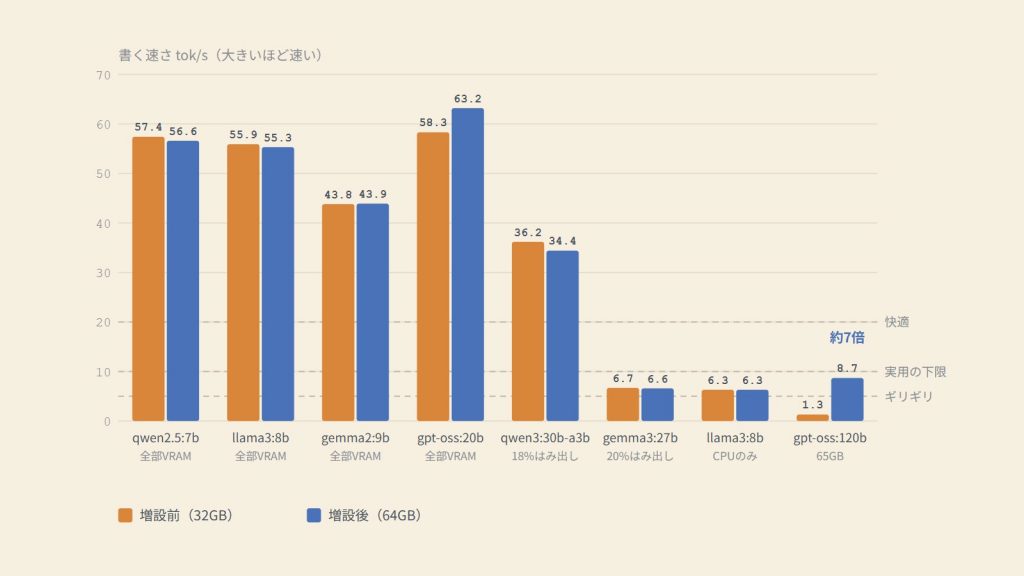
- メモリ増設でVRAMの「容量」の代わりはできる。32GBでは入らなかった65GBのAI(gpt-oss:120b)が、64GBに増やすと1.3 → 8.7 tok/s(約7倍)になった。
- しかし「速さ」の代わりにはならない。VRAMから少しはみ出していたモデルは、増設しても1ミリも速くならなかった(6.7 → 6.6 tok/s)。速さはメモリの帯域で決まるから。
- 話題の小型PCが速いのは、メモリ自体が普通のPCの約7倍速い特別な作りだから。同じ速さを自作で再現しようとすると、本体価格に近い金額がかかる。
きっかけ:128GBメモリのPCで80GB級のAIが動いた
PC Watch に、マウスコンピューターの小型PC「DAIV CX」で大型のローカルAIを動かした検証記事が載りました。CPUは Ryzen AI Max+ 395、メモリは128GBで、そのうち最大96GBをGPU用に割り当てられます。記事では、65GBの gpt-oss-120b が 46.5 tok/s、87GBの GLM-5.3-Flash が 13.1 tok/s で動いていました。
普通のグラフィックボードのVRAMは16〜32GBです。それを考えると、80GB級が「メモリで」動くのは大きな話です。では、手元のPCにメモリを足せば同じことができるのか。これを実際に確かめました。
これまでの記事で、VRAMからはみ出すと遅くなること(はみ出しても答えの中身は変わらない話)や、どのくらいの速さなら仕事に使えるか(速度の許容値の話)を書いてきました。今回はその続きです。
検証に使ったPCとやり方
| 項目 | 内容 |
|---|---|
| GPU | AMD Radeon RX 9060 XT(VRAM 16GB) |
| CPU | Core i7-7700(4コア・2017年の世代) |
| メモリ(増設前) | 8GB×4枚=32GB(DDR4-2400 デュアルチャネル) |
| メモリ(増設後) | 8GB×2枚+32GB×2枚=80GBを挿入 → CPUの上限で64GBとして認識(速さは同じDDR4-2400) |
| 実行環境 | Ollama(ROCm)。APIを直接叩いて計測 |
| 条件 | temperature 0 / seed固定 / 短い質問3問+契約書を読ませる1問(約2,300トークン) |
これまでの記事と同じ「3号機」です。測ったのは、書く速さ(1秒あたりに出せるトークン数)と、読む速さ(資料を読み込む速さ)、それに資料を渡してから最初の1文字が出るまでの時間です。
モデルは、VRAMに全部載る小さいもの(7B〜20B)から、少しはみ出すもの(27B〜32B)、VRAMの約4倍ある gpt-oss:120b(65GB)まで並べました。比較用に、8BのモデルをわざとGPUを使わずCPUとメモリだけで動かした条件も入れています。
増設前:はみ出した瞬間に遅くなる
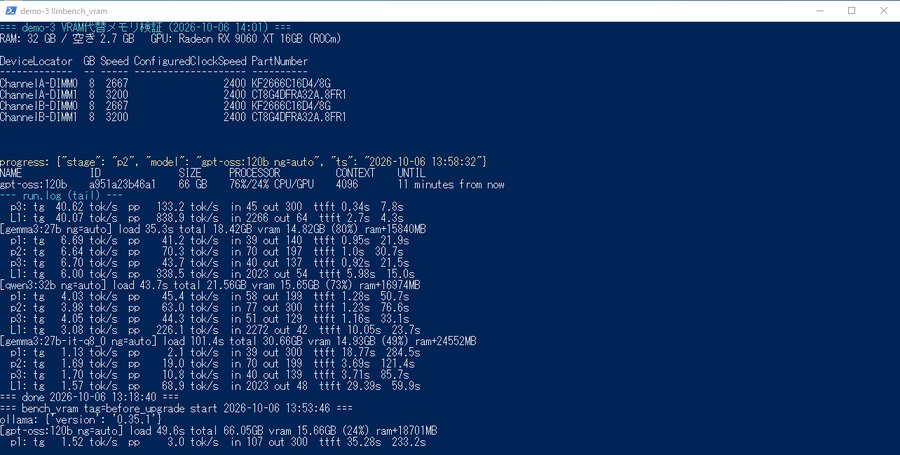
まず、メモリ32GBの状態での結果です。
- VRAMに全部載るモデルは、7Bでも20Bでも約44〜58 tok/sで快適でした。
- VRAMから20%はみ出した gemma3:27b は6.7 tok/s、27%はみ出した qwen3:32b は4.0 tok/s に落ちました。
- 65GBの gpt-oss:120b は、メモリ32GBにも入りきらず、SSDから読みながら動く状態でした。書く速さは1.3 tok/s、資料を渡してから最初の1文字まで151秒かかりました。
- 例外は qwen3:30b-a3b です。18%はみ出しても36 tok/sと速いままでした。これは「MoE」という、1文字ごとにモデルの一部(30Bのうち3B分)しか使わない作りのためです。
増設後:変わったのは120bだけ
メモリを64GBにして、同じモデル・同じ質問で測り直しました。
| モデル | 置き場所 | 増設前 32GB | 増設後 64GB |
|---|---|---|---|
| qwen2.5:7b | VRAMに全部 | 57.4 | 56.6 |
| llama3:8b | VRAMに全部 | 55.9 | 55.3 |
| gemma2:9b | VRAMに全部 | 43.8 | 43.9 |
| gpt-oss:20b | VRAMに全部 | 58.3 | 63.2 |
| qwen3:30b-a3b(MoE) | 18%はみ出し | 36.2 | 34.4 |
| gemma3:27b | 20%はみ出し | 6.7 | 6.6 |
| llama3:8b | CPUとメモリだけ | 6.3 | 6.3 |
| gpt-oss:120b(MoE・65GB) | 76%はみ出し | 1.3 | 8.7 |
単位は tok/s(短い質問3問の中央値)。gpt-oss:120b の増設後は2回目の計測値(1回目は読み込み中のため1問ごとに5.0→6.0→8.8→10.8と加速した)。
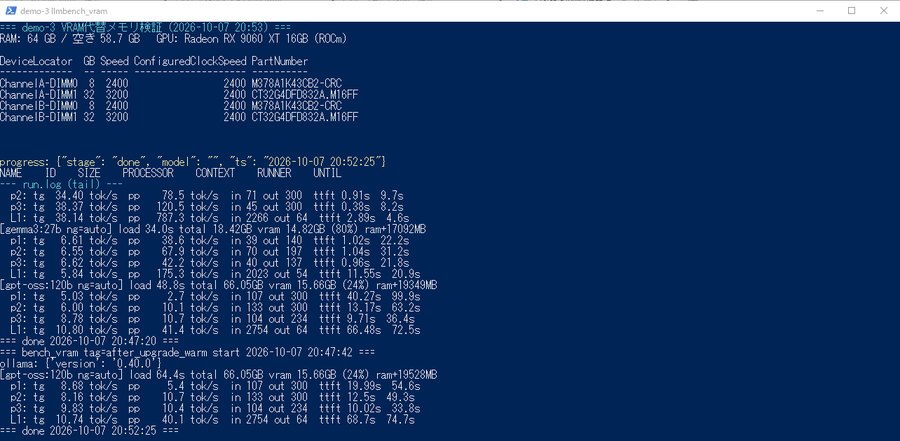
gpt-oss:120b だけが1.3 → 8.7 tok/sと約7倍になりました。資料を渡してから最初の1文字が出るまでも、151秒 → 69秒に縮みました。増設前はメモリに入りきらずSSDから読んでいたのが、増設後はメモリに全部収まったためです。実測前に計算式で立てた予測(5〜10 tok/s)の範囲にも入りました。
一方、それ以外のモデルはまったく変わりませんでした。20%はみ出していた gemma3:27b も、CPUだけで動かした8Bも同じ速さです。
なぜ速くならないのか:速さはメモリの「道幅」で決まる
AIは1文字(1トークン)書くたびに、使う部分の重みをメモリから全部読み直します。計算よりも読み出しが追いつかないのが遅さの正体です。前々回の記事で示した式を、ざっくり書くとこうなります。
帯域=1秒間にメモリから読み出せる量(GB/s)。はみ出した分は、遅い方のメモリの帯域で決まる
メモリを増設して増えるのは容量(入る量)だけで、帯域(読み出す速さ)は変わりません。3号機のメモリは増設後もDDR4-2400のままなので、はみ出した分を読む速さは同じです。だから、もともとメモリに収まっていたモデルは速くなりませんでした。
120bが速くなったのは例外ではありません。SSD(1秒に数GB)から読んでいたものが、メモリ(1秒に約25GB)から読めるようになっただけです。「入らない」が「入る」に変わる時だけ、増設は効きます。
DAIV CXは、メモリの遅さをハードでどう解決しているか
では、DAIV CXはなぜ「メモリで」80GB級を速く動かせるのか。答えは、メモリそのものが普通のPCとまったく違う作りだからです。ポイントは4つあります。
① 道幅が2倍(256bit)
普通のデスクトップPCのメモリの通り道は128bit(2チャネル)です。Ryzen AI Max+ 395 は256bitあり、一度に運べる量が倍になります。3号機(DDR4・128bit)と比べると、道幅と速度を合わせて約7倍です。
② スマホ用の高速メモリ(LPDDR5X-8000)
使っているのは、スマホやノートPC向けの省電力・高速なメモリです。1本あたりの速さが、一般的なデスクトップ用DDR5(5600前後)より4割ほど速い規格です。
③ 基板に直付け(交換・増設はできない)
256bitもの信号を8000MT/sで通すには、メモリをチップのすぐ近くにはんだ付けする必要があります。差し込み式のメモリでは同じ速さが出せません。代わりに、買った後に増設はできず、128GBが上限です。
④ CPUとGPUが同じメモリを使う(ユニファイドメモリ)
普通のPCは「VRAM」と「メモリ」が別々で、はみ出した分はCPUが計算します。DAIV CXは1つのメモリを共有し、最大96GBをGPU用に割り当てられます。はみ出しという考え方自体がなく、GPUが全部を読みにいけます。
つまり、「メモリでVRAMの代わりをする」のではなく、VRAM並みに速いメモリを大量に積んでいると考えるのが正確です。帯域は理論値で256GB/sあり、3号機のグラフィックボード(320GB/s)の8割に届きます。
弱点もあります。内蔵GPUの計算力は単体のグラフィックボードより低く、資料を読む速さ(プロンプト処理)が遅めです。PC Watchの記事でも、25ページの資料を渡すと回答完了まで29分かかっていました。また、VRAMに収まる中型モデル(27B級)では、ハイエンドのグラフィックボードを積んだPCの方が速かったと書かれています。
同じものを自分で組んだら、いくらかかるか
DAIV CX の直販価格は税込949,800円です(Windows、2TB SSD、国内保証込み)。同じ考え方のPCを自分で用意する方法を、4通り見積もりました。
| 方法 | メモリ帯域(理論値) | 載る量 | 概算費用(税込) | 120bの速さ(目安) |
|---|---|---|---|---|
| DAIV CX(参考) | 256GB/s | 128GB | 949,800円 | 46.5(PC Watch実測) |
| A. 同じチップのミニPCを買う | 256GB/s | 128GB | 約58万円 | DAIVと同等 |
| B. 同じチップのマザーボードで組む | 256GB/s | 128GB | 約61万円 | DAIVと同等 |
| C. 一般の部品で帯域を近づける | 205GB/s | 最大256GB | 約87万円 | 30〜45 |
| D. 普通の自作PC+メモリ128GB | 83GB/s | 128GB | 約52万円 | 15〜20 |
| (参考)3号機+増設 | 38GB/s | 64GB | ― | 8.7(今回実測) |
2026年10月8日時点の公開価格・相場からの概算。メモリ価格が高騰中で、数週間で1割以上動くことがあります。為替は1ドル150円で計算。120bの速さは、今回の実測(帯域38GB/sで8.7 tok/s)から帯域の比で見積もった目安で、DAIVの実測(46.5)とほぼ合います。
A. 同じチップのミニPCを買う(約58万円)
Ryzen AI Max+ 395 と128GBを積んだミニPCは他社からも出ています。たとえば GMKtec EVO-X2(128GB/2TB)は公式ストアで583,000円です。中身の性能はDAIV CXとほぼ同じで、差額の約37万円は、国内メーカーの保証・サポートや部品選定の違いと考えられます。なお、このミニPCも発売時は約42万円でした。メモリ高騰で4割近く上がっています。
B. 同じチップのマザーボードで組む(約61万円)
このチップはメモリが直付けのため、CPUとメモリを別々に買うことはできません。「自作」に一番近いのは、Framework 社が単体で売っているMini-ITXサイズのマザーボード(CPUと128GBメモリが付いた状態)を使う方法です。
| 部品 | 概算 |
|---|---|
| Framework Desktop マザーボード(Ryzen AI Max+ 395・128GB) | 約472,000円(3,149ドル) |
| 送料・輸入時の消費税など | 約50,000円 |
| Mini-ITXケース | 約15,000円 |
| 電源(SFX 500W前後) | 約15,000円 |
| CPUクーラー | 約8,000円 |
| SSD 2TB | 約35,000円 |
| Windows 11 | 約19,000円 |
| 合計 | 約61万円 |
組み立ての手間をかけても、完成品のミニPCより安くはなりません。マザーボード自体が完成品と同じ部品だからです。
C. 一般の部品で帯域を近づける(約87万円)
差し込み式のメモリで帯域を稼ぐには、メモリの通り道(チャネル)が多いCPUを使います。ワークステーション向けの Threadripper 9960X は4チャネルで、DDR5-6400を使うと理論205GB/s。DAIVの8割です。
| 部品 | 概算 |
|---|---|
| CPU:Threadripper 9960X(24コア) | 約272,000円 |
| マザーボード:TRX50 | 約155,000円 |
| メモリ:DDR5-6400 RDIMM 32GB×4枚=128GB | 約240,000円 |
| グラフィックボード:RX 9060 XT 16GB(CPUに内蔵GPUが無いため必須) | 約65,000円 |
| CPUクーラー・電源1000W・ケース | 約80,000円 |
| SSD 2TB・Windows 11 | 約54,000円 |
| 合計 | 約87万円 |
DAIVとほぼ同じ金額で、帯域は8割です。その代わり、メモリを後から256GBまで増やせて、グラフィックボードも交換できます。VRAM 16GBに載る部分はGPUで速く動くので、120bなら30〜45 tok/sが見込めます。
D. 普通の自作PCにメモリ128GB(約52万円)
一般的なデスクトップ(Ryzen 7 + B850マザーボード)に、DDR5を4枚挿して128GBにする方法です。メモリだけで約28万円かかります。それでも帯域は2チャネルのままで、4枚挿しだと速度も下がるため理論83GB/sです。容量はDAIVと同じでも、速さは約1/3になります。今回の3号機の増設と同じ「入るけど速くはない」構成です。
許容値で見ると、どれを選ぶべきか
前回の記事の基準では、チャットで快適なのは20 tok/s以上、実用の下限が10 tok/s、5 tok/s以下は夜間の自動処理向けです。この基準で整理するとこうなります。
- 3号機+増設(8.7 tok/s):120bが「動く」ようにはなりましたが、会話には少し遅いです。1件10分程度の急がない仕事向けです。資料を読ませると最初の返事まで約1分かかります。
- D. 普通の自作+128GB(15〜20 tok/s):実用ラインには届きます。ただし資料を読む速さはGPUに頼れないので遅めです。
- A〜C、DAIV(30〜46 tok/s):120bを会話で快適に使えます。ただし費用は60〜95万円です。
もう1つ大事なのは、120bと20bの賢さの差が思ったほど大きくないことです。第三者機関 Artificial Analysis の総合評価では、gpt-oss-120b が12点、gpt-oss-20b が9点でした。20bはVRAM 16GBに全部載り、60 tok/s前後で快適に動きます。「とにかく大きいモデル」を目指すより、VRAMに載る範囲で一番良いモデルを選ぶ方が、多くの業務では割に合います。
おまけ:増設後にAIがGPUを使わなくなった話
増設後に最初に測ったとき、7Bの小さいモデルまでGPU 0%(CPUだけ)で動いていました。原因はメモリではなく、Ollama の自動アップデートが途中で止まったことでした。アップデート中にシャットダウンしたため、AMDのGPUを使うための部品(ROCm)が丸ごと欠けていました。Ollamaを入れ直すと元に戻りました。
増設や再起動の後に「急に遅くなった」と感じたら、ollama ps で「100% GPU」と出ているかを最初に確認するのがおすすめです。
まとめ
- メモリ増設は、入らなかったモデルを動かすためには効く。今回は120bが1.3 → 8.7 tok/s になった。
- メモリ増設で、はみ出したモデルが速くなることはない。速さはメモリの帯域で決まり、普通のPCのメモリはVRAMの約1/8しかない。
- DAIV CXが速いのは、256bit・LPDDR5X-8000の直付けメモリをCPUとGPUで共有しているから。メモリがVRAM並みに速い。
- 同じ帯域を自分で用意すると60〜90万円。部品を選んで組んでも、完成品より大きく安くはならない。
- 多くの業務では、VRAMに載る範囲で良いモデルを選ぶのが一番コスパが良い。
出典・参考
- PC Watch「マウスコンピューター『DAIV』から登場した128GBメモリ搭載ローカルLLM向けPC。大規模モデルの実力に迫る」(2026年9月24日)
https://pc.watch.impress.co.jp/docs/topic/special/2141205.html - エルミタージュ秋葉原「マウス、Ryzen AI Max+ 395と128GBメモリ搭載小型PC『DAIV CX-A9A60』」
https://www.gdm.or.jp/pressrelease/2026/0824/649291 - AMD「Ryzen AI Max+ 395」製品ページ
https://www.amd.com/en/products/processors/desktops/ryzen/ryzen-ai-halo/ryzen-ai-max-plus-395.html - Framework「Framework Desktop Mainboard」
https://frame.work/products/framework-desktop-mainboard-amd-ryzen-ai-max-300-series - GMKtec「EVO-X2」公式ストア
https://jp.gmktec.com/products/gmktec-evo-x2-amd-ryzen%E2%84%A2-ai-max-395-mini-pc - 価格.com「AMD Ryzen Threadripper 9960X BOX」
https://kakaku.com/item/K0001702503/ - ゲーミングスタイル「DDR5メモリ価格推移【2026年10月】」
https://gaming-st.com/gamingpc/664/ - Artificial Analysis「LLM Leaderboard」
https://artificialanalysis.ai/leaderboards/models - 弊社ブログ「VRAMからはみ出したAIは、頭が悪くなるのか? 実測と計算式で確かめた」
https://syushi.com/blog/local-llm-offload-accuracy-speed/ - 弊社ブログ「ローカルAIの「遅さ」はどこまで許せるか? チャットをやめて自動化すれば見えてくる答え」
https://syushi.com/blog/local-llm-speed-tolerance/