— Blog
ローカルAIの「遅さ」はどこまで許せるか? チャットをやめて自動化すれば見えてくる答え
目次
前回の記事で、VRAMの2倍の大きさのAIモデルは「1秒に約3文字。答えの質は変わらないが、対話で使うには遅すぎる」と書きました。ただ、書いたあとで思いました。そもそも、人が画面の前で答えを待つ必要はあるのでしょうか。チャットではなく、仕事を渡して夜のうちにやっておいてもらう使い方なら、遅さはどこまで許せるのか。今回は、弊社の実際の開発・改修案件でAIがやり取りした量をもとに計算し、ボタンを押して速さを体感できる形にしました。
この記事の結論(3行)
- チャットとして使うなら、VRAMに全部載るモデルでないと待てない。はみ出すと、画面の前で数分〜数十分待つことになる。
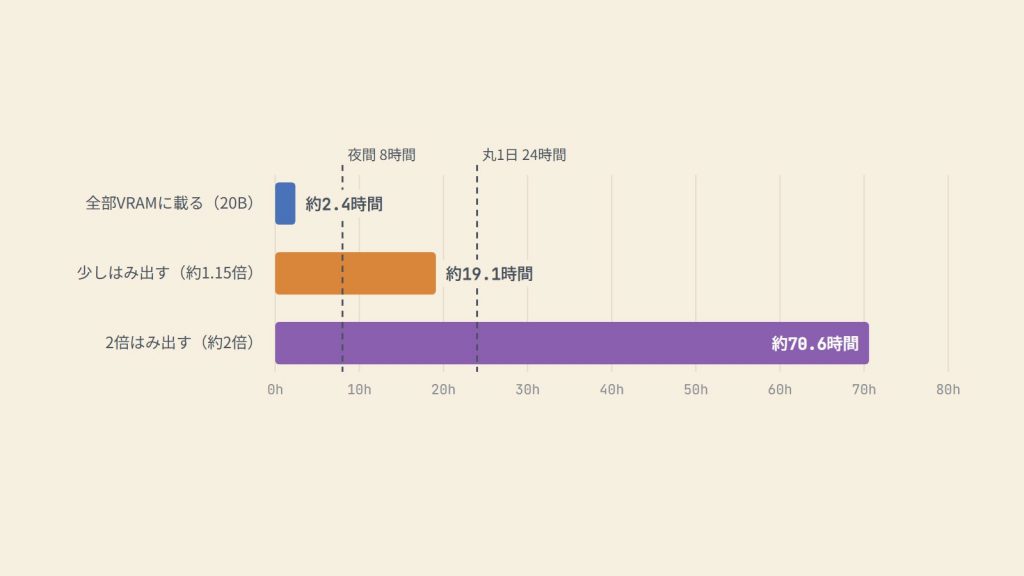
- ただし自動化して人が待たない使い方なら話は別。VRAMから少しはみ出す程度(約1.15倍)のモデルなら、弊社の1日分のAI作業量を約19時間で処理できる計算になった。
- VRAMの2倍までいくと、1日分に約71時間かかる。夜間に回しても追いつかないので、「急がない仕事を選んで渡す」使い方に限られる。
まずは体感:同じ会話を、3つの速さで同時に再生する
下のボタンを押すと、同じ会話が3つの速さで同時に始まります。内容は、弊社の実際の開発・改修案件で行ったAIとのやり取りをもとに、お客様やシステムが特定されないよう書き換えたものです(1つ目は計算の修正の影響範囲の調査、2つ目はお客様への返信メールの作成)。
速さは、前回の記事と同じPC(VRAM 16GB)での実測値です。「書く」は答えを書き出す速さ、「読む」は資料や質問文を読み込む速さです。AIは答えを書く前に、まず渡された資料を読みます。その間は画面に何も出ません。
※ 速さは検証PC(Radeon RX 9060 XT 16GB / Core i7-7700 / DDR4-2400 32GB・Ollama)での実測値。1トークン=約1.8文字で換算。AIが最初に読む資料の量(約8,000トークン・約3,000トークン)は、この見本のための想定です。ボタンを押すまで何も動きません。
結果は、左から約15秒、約1分50秒、約6分30秒です。左は、打ち終わったらもう答えが出ている感覚です。真ん中は、読む速さよりは遅いものの、なんとか画面の前で待てる速さです。右は、1通目の答えを待つ間にコーヒーを淹れに行けます。
画面に見える文字は、氷山の一角
実は、この見本は実際の仕事量よりかなり軽くしてあります。1つ目のやり取りを実際にAIに頼んだときは、答えの文章(約240トークン)の裏で、AIは約12,000トークンを書き(考える・ファイルを探す指示・修正案の検討など)、約18,000トークンを読んでいました。見えている答えは全体の2%ほどです。
この本当の量で計算し直すと、1つ目のやり取りだけで、全部載るモデルなら約4分、少しはみ出すモデルなら約32分、2倍はみ出すモデルなら約2時間かかります。ここまで来ると、画面の前で待つ前提はもう成り立ちません。
発想を変える:ローカルAIは「待たせない」使い方が向いている
クラウドのAIは、使った量に応じて料金がかかります。一方、ローカルAIは何時間動かしても追加の料金がかかりません。電気代だけです。しかもデータが社外に出ません。
それなら、人が話しかけて答えを待つ「チャット」にこだわる必要はありません。たとえば次のような使い方なら、答えが出るのが数十分後でも、翌朝でも困りません。
- メールの返信案づくり:届いたメールを夜のうちに読ませて、朝には返信案が揃っている
- プログラムの修正案づくり:修正依頼を渡しておき、翌朝に修正案と影響範囲の報告を確認する
- 書類のチェック:その日に作った見積書や報告書を夜間に読み直させ、気になる点を一覧にしておく
つまり、速さの許容値は「使い方」で決まります。では、実際の仕事量で計算すると、どのくらいの速さがあれば回るのでしょうか。
実際の仕事量で計算する
弊社では、開発・改修の仕事でAI(クラウドのAI)を日常的に使っています。そのやり取りの記録から、依頼1回あたりにAIが読んだ量と書いた量を集計しました。
| 集計の対象 | 内容 |
|---|---|
| 期間 | 2026年7月22日〜9月30日(稼働59日) |
| 案件 | 弊社の開発・改修案件 6件 |
| 依頼の数 | 1,494件(人がAIに指示を出した回数) |
| 数えたもの | AIが書いたトークン数(考える・ファイルを書く等を含む)と、新しく読んだトークン数 |
| 少ない依頼 (下から25%) |
ふつうの依頼 (中央値) |
多い依頼 (上から25%) |
1日分 (中央値) |
|
|---|---|---|---|---|
| AIが書いた量 | 約1,800 | 約5,600 | 約16,000 | 約39万 |
| AIが読んだ量 | 約1.9万 | 約5.4万 | 約16万 | 約275万 |
| 依頼の数 | ― | ― | ― | 23件 |
(単位はトークン。1日分は、その日の依頼をすべて足した量の中央値です。)
読む量が書く量の約10倍あるのが特徴です。AIは仕事の前に、プログラムや仕様書、過去のやり取りを大量に読んでいます。
所要時間の計算式
書く速さ・読む速さは、上の体感デモと同じ実測値(トークン/秒)
この式に、上の仕事量と3つの速さを入れると次のようになります。
| 速さ | ふつうの依頼1件 | 多い依頼1件 | 10分以内に終わる依頼 | 1日分の仕事 |
|---|---|---|---|---|
| 全部VRAMに載る(20B) | 約2.6分 | 約6.4分 | 84% | 約2.4時間 |
| 少しはみ出す(約1.15倍) | 約20分 | 約51分 | 31% | 約19時間 |
| 2倍はみ出す(約2倍) | 約72分 | 約3時間 | 6% | 約71時間 |
許容値はどこにあるのか
使い方ごとに「待てる時間」を決めると、どの速さなら足りるかが見えてきます。
| 使い方 | 待てる時間の目安 | 全部載る | 少しはみ出す | 2倍はみ出す |
|---|---|---|---|---|
| チャット(画面の前で待つ) | 数秒で書き始め、読む速さで書く | ○ | △ 読む速さより遅い | × 1秒に約3文字 |
| 依頼して別の作業をする | 1件10分くらい | ○ 2.6分 | △ 20分 | × 72分 |
| 夜間だけ自動で回す | 1日分を8時間で | ○ 2.4時間 | × 19時間 | × 71時間 |
| 24時間自動で回す | 1日分を24時間で | ○ | ○ 19時間 | × 71時間 |
逆に、「この時間で終わらせたい」から必要な速さを出すこともできます。
例:1日分(書く39万・読む275万)を24時間で、読む速さ290トークン/秒のPCなら
390,000 ÷(86,400秒 - 2,750,000 ÷ 290)≒ 毎秒5トークン。少しはみ出すモデル(6.5)で足りる
同じ計算で、1日分を夜間8時間で終わらせたいなら毎秒約20トークン、ふつうの依頼1件を10分で返したいなら毎秒約14トークンが必要です。
まとめると、VRAMから少しはみ出す程度なら「24時間動かし続ける自動化」で実用になり、2倍までいくと自動化しても追いつかないというのが、弊社の仕事量での答えでした。2倍はみ出すモデルは、1晩(8時間)で「ふつうの依頼」を約7件です。急がない仕事を選んで渡す、という使い方になります。
正直に書いておくこと
- 仕事量はクラウドAIでの実績です。ローカルの20B〜27Bのモデルが、同じ仕事を同じ品質でこなせるわけではありません。ここでの数字は「仕事の量の物差し」として使っています。複雑な改修は、ローカルAIでは一度で終わらず、やり直しが増える可能性があります。
- 読む量は多めに出ています。クラウドAIの記録では、しばらく間が空くと同じ資料を読み直した分も数えられます。ローカルAIで同じ資料を使い回す工夫をすれば、読む時間は減らせます。一方で、資料が長くなるほど読む速さは落ちるので、その逆の効果もあります。
- 1台で1件ずつ順番に処理する前提です。複数の依頼を同時に処理する設定にすれば、全体の処理量が増える場合があります。
- 見本の会話は書き換えています。お客様やシステムが特定されないよう、名前・画面名・数値などを変えています。
まとめ:遅いローカルAIは「夜勤」に回す
ローカルAIを選ぶとき、つい「チャットで快適に使えるか」で考えてしまいます。しかし、ローカルAIの強みは料金を気にせず、データを外に出さず、ずっと動かし続けられることです。その強みを活かすなら、人が待つチャットではなく、仕事を渡して結果だけ受け取る自動化のほうが向いています。
そう考えると、許容できる速さはぐっと下がります。VRAMに全部載る速いモデルは昼のチャット用、少しはみ出す賢いモデルは24時間の自動処理用、というように使い分けるのも一つの手です。
次回は、この計算式を使って「このPCで最高クラスのローカルAIを動かしたら、1日分の仕事に何時間かかるのか」を予測してみる予定です。
弊社では、こうした検証結果をもとに「業務データを外に出さないローカルAI環境」の構築や、業務の自動化のご相談を承っています。お気軽にお問い合わせください。
参考・出典
- 前回の記事: VRAMからはみ出したAIは、頭が悪くなるのか? 実測と計算式で確かめた https://syushi.com/blog/local-llm-offload-accuracy-speed/
- 前々回の記事: ローカルAIのPC選び、決め手は「世代」より「VRAM」だった https://syushi.com/blog/local-llm-gpu-vram-benchmark/
- Ollama https://ollama.com/
- 速度はすべて弊社の実測(2026年9月28〜30日)。全部載る=gpt-oss:20b、少しはみ出す=gemma3:27b(Q4_K_M)、2倍はみ出す=gemma3:27b(q8_0)。
- 仕事量は弊社の開発・改修案件でのAI利用記録(2026年7月22日〜9月30日・依頼1,494件)から集計。