— Blog
ローカルAIのPC選び、決め手は「世代」より「VRAM」だった
この記事は、弊社が実施した検証データをもとに AI(Claude)で記事を生成し、人が内容を確認したうえで公開しています。図表・計測値は弊社の実測です。
「AIをローカルで動かすPCが欲しい。GPUは新しいほど速いんでしょ?」──そう思って、手元にあるGPUの違う3台に同じモデルを載せて測ってみたら、結果は少し違いました。新しい世代のGPUが、古い世代のGPUに負ける場面があったのです。理由は一つ、VRAM(GPUのメモリ)の容量でした。
この記事の結論(3行)
- ローカルAIの速さは、モデルがVRAMに丸ごと収まるかどうかでほぼ決まる。収まらないと速度は一気に落ちる。
- GPUの「世代」や「演算性能」は、VRAMに収まっている限りは差が出にくい。7〜8Bクラスなら3台とも横一線だった。
- 賢いモデルほど大きく、大きいモデルほどVRAMを食う。だから「どのくらい賢いAIを回したいか」=「VRAMを何GB積むか」で選ぶ。
何を試したのか
きっかけは、あるお客様向けに「業務データを一切外に出さずにAIを使いたい」というご相談をいただき、ローカルLLM(PC内で完結する大規模言語モデル)を動かすPCを組んで検証したことです。クラウドのAIは便利ですが、契約書や個人情報を扱う現場では「データがどこに行くのか」が最初の壁になります。ローカルで動けば、その心配がそもそも無くなります。
検証の途中で、GPUの違う3台が手元に揃いました。せっかくなので、同じモデル・同じ条件で3台を横並びにして「どこで差がつくのか」を測ってみることにしました。本記事は、その結果を技術的な観点でまとめたものです。
検証に使った3台
偶然ですが、3台は「世代」と「VRAM容量」がきれいにねじれています。1号機はいちばん新しい世代なのにVRAMが最も少なく、2号機は最も古い世代なのにVRAMは中間、3号機はAMD製で最もVRAMが多い、という構成です。
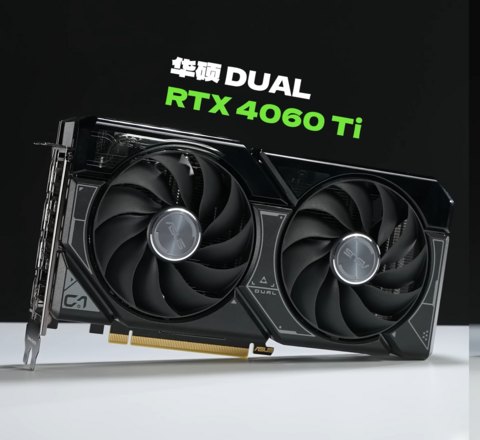
RTX 4060 Ti / 8GB
1号機 ─ Ada Lovelace世代(2023)
RTX 2060 / 12GB
2号機 ─ Turing世代(2019)
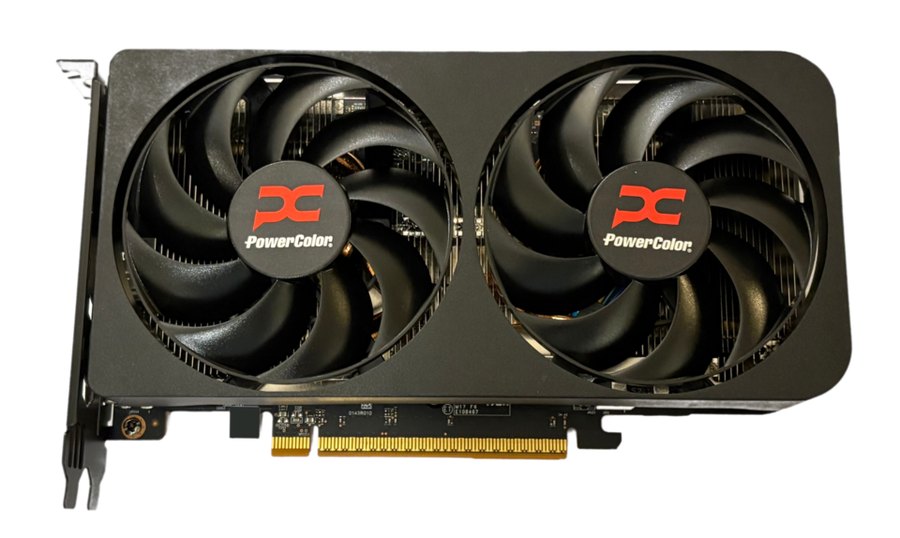
RX 9060 XT / 16GB
3号機 ─ RDNA 4世代(2025)
| 1号機 | 2号機 | 3号機 | |
|---|---|---|---|
| GPU | GeForce RTX 4060 Ti | GeForce RTX 2060 | Radeon RX 9060 XT |
| VRAM | 8GB GDDR6 | 12GB GDDR6 | 16GB GDDR6 |
| VRAM帯域 | 288 GB/s | 336 GB/s | 320 GB/s |
| GPU世代 | Ada(2023) | Turing(2019) | RDNA 4(2025) |
| CPU | Core i5-14400F | Core i7-10700T(省電力35W) | Core i7-7700 |
| メモリ | 32GB | 48GB | 16GB |
| 推論バックエンド | CUDA | CUDA | ROCm |
CPUや本体メモリもバラバラですが、後述のとおりモデルがVRAMに収まっている間はCPUの差はほぼ出ません。逆に、収まらなくなった瞬間からCPUと本体メモリの性能が顔を出します。
測り方
- 実行環境: Ollama(ローカルLLMの実行基盤)。Web UIは経由せず、APIを直接叩いて応答に含まれる計測値を採る
- 指標: 生成速度
tok/s(1秒あたりに生成するトークン数。日本語なら1トークン≒1〜2文字)。人が読む速さの目安が15〜20 tok/sなので、それを超えていれば「待たされない」体感になる - モデル: 7B級(qwen2.5:7b)/8B級(llama3:8b)/9B級(gemma2:9b)/20B級(gpt-oss:20b)の4種。いずれもOllama標準の量子化(4bit前後)
- 条件: 数千文字の業務文書を読ませる長文プロンプト。ウォームアップ1回を捨てて3回計測の中央値。あわせてGPU使用率(モデルの何%がGPUに載ったか)も記録
結果①:7〜8Bまでは、3台とも横一線
まず目を引くのは、7B・8Bクラスでは3台の差がほとんど無いことです。2023年のRTX 4060 Tiも、2019年のRTX 2060も、AMDのRX 9060 XTも、50〜55 tok/s前後で並びました。4年分の世代差は、この用途ではほぼ見えません。
理由は単純で、LLMの文章生成は「演算」よりも「メモリからモデルの重みを読み出す速さ」に縛られる処理だからです。3枚ともVRAM帯域は300 GB/s前後で大差なく、7〜8Bのモデル(約4.7GB)がVRAMに丸ごと収まっている限り、ほぼ同じ速さで頭打ちになります。
結果②:9Bで「8GBの壁」、20Bで「12GBの壁」が現れる
差がつき始めるのは9Bクラス(gemma2)からです。いちばん新しい1号機(8GB)だけが失速し、GPU使用率は80%──つまりモデルの2割がVRAMに入りきらずCPU側に漏れました。結果、古い2号機(12GB)に20%以上の差をつけられています。
20Bクラス(gpt-oss)ではさらにはっきりします。3号機(16GB)だけがモデル全体(約13GB)をVRAMに載せて54 tok/s。8GBの1号機と12GBの2号機は、それぞれGPU使用率44%・70%で、どちらも30 tok/s台まで落ちました。
興味深いのは、20BクラスでVRAMの多い2号機(12GB)が、少ない1号機(8GB)に負けている点です。2号機はVRAMに70%載っているのに、8GBで44%しか載っていない1号機より遅い。これは、VRAMから溢れた分を処理するCPUが、2号機は省電力版(i7-10700T・35W)で非力だったためです。溢れた瞬間から「GPUの勝負」ではなく「CPUと本体メモリの勝負」に変わる──このことが、VRAMの重要さを裏側から示しています。
なぜ「世代」で勝てないのか:溢れた瞬間に速度が1/6になる
LLMは1トークン生成するたびに、モデルの重み全体をメモリから読み直します。20Bモデルなら毎回13GBです。VRAMなら300 GB/sで読めるので1回あたり約0.04秒、これが「1秒に20〜50トークン」の正体です。ところがVRAMから溢れた部分は、本体のDDR4メモリ(約50 GB/s)から読むことになり、その部分だけ6〜7倍遅い。GPUがどれだけ新しくても、この足かせは外せません。
つまり、「GPUの世代が新しい=速い」が成り立つのはモデルがVRAMに収まっている場合だけで、収まらなければ世代の差はメモリ帯域の差に飲み込まれてしまいます。
では、なぜ大きいモデルにこだわるのか:賢さはサイズに乗る
「7Bで足りるなら8GBでいいじゃないか」という考え方もあります。ただ、実務で使うなら話は別です。同じ設問セット(雑談・応答精度・事実の正確さ・長文作成の56問)を各モデルに解かせて5点満点で採点したところ、モデルサイズと回答品質にはきれいな相関がありました。
7Bクラスは「無難だが踏み込みが浅い」、20Bクラスは「提案資料がそのまま使えるレベル」という体感差があり、業務で使うほど大きいモデルが欲しくなります。すると必要なVRAMも増える。「賢さ → モデルサイズ → VRAM」という一本の線でつながっているのが、ローカルAIのPC選びの本質です。
16GBの先へ:20B超えモデルと「2枚差し」の実験
3号機(16GB)で、20Bを超えるモデルも試しました。結果は次のとおりです。
| モデル | サイズ | 生成速度 | 回答品質 | 事実の正確さ | 備考 |
|---|---|---|---|---|---|
| gpt-oss:20b | 約13GB | 52 tok/s | 3.7 | 2.4 | 速いが数値・期限を堂々と間違える |
| qwen3:30b-a3b | 約19GB(MoE) | 19 tok/s | 3.9 | 3.0 | 3GB分溢れても実用速度。ツール呼出精度95% |
| mistral-small3.2:24b | 約15GB | 9 tok/s | 4.0 | 4.1 | 最も正確。gpt-ossが誤った法律系設問を正答 |
| qwen3:32b | 約22GB(密) | 2.7 tok/s | ─ | ─ | 16GBでは実用不可。途中で打ち切り |
ここでも同じ構図です。VRAMに収まる20Bは快速、3GB溢れる30B-A3Bはギリギリ実用、6GB溢れる32Bは使い物にならない。一方で、正確さを求めるほど大きいモデルが欲しくなることも数字に出ています(mistral-small3.2の事実正確性4.1は、gpt-ossの2.4とは別次元です)。
GPUを2枚挿してVRAMを合算してみる
そこで、3号機に手元にあった旧世代のRadeonを追加して「VRAMを合算できるか」を試しました。OllamaはAMDのROCmとVulkanという2種類の実行ライブラリを持っており、同じライブラリで認識されたGPU同士でしか1つのモデルを分割しません。新しい9060 XTはROCm、古いカードはVulkanでしか動かないため、そのままでは合算されませんでした。両方をVulkanに揃えると合算に成功しています。
| モデル | 9060 XT 1枚(ROCm) | 2枚合算(Vulkan統一) |
|---|---|---|
| gpt-oss:20b | 59 tok/s | 36 tok/s |
| qwen3:30b-a3b | 溢れる | 54 tok/s(GPU100%) |
| gemma3:27b | 5.8 tok/s | 12.6 tok/s |
| qwen3:32b | 3.6 tok/s | 9.5 tok/s |
合算すると30B-A3Bが丸ごと載って54 tok/sまで跳ね上がる一方、Vulkanは9060 XT単体ではROCmの6割程度の速さになるというトレードオフもありました。「合算は効くが、ライブラリの相性という新しい壁が出てくる」というのが現時点の手応えです。ここは今後もっと良くなる余地が大きい領域だと感じています。
これからに期待していること
今回の検証で見えたのは「VRAMが天井を決める」という現在地ですが、その天井は確実に上がりつつあります。個人的に期待している方向を4つ挙げます。
① ミドル帯GPUのVRAM大容量化
2025年のRX 9060 XTやRTX 5060 Tiには16GB版が用意されました。数年前なら上位機にしかなかった容量が、10万円を切る価格帯まで降りてきています。この流れが続けば「20B級を全載せ」が普通のデスクトップで当たり前になります。
② MoE(専門家混合)モデルの普及
今回のqwen3:30b-a3bのように「30B分の知識を持ちながら、毎回動くのは3B分だけ」というモデルは、VRAMさえあれば小型モデル並みの速さで大型モデルの賢さを出せます。VRAM容量の価値がますます高まる方向です。
③ 統合メモリ(CPU・GPU共有)という選択肢
Apple SiliconやAMD Ryzen AI Maxのように、本体メモリをそのままGPUが使えるアーキテクチャなら「VRAMの壁」自体が薄くなります。帯域はまだGDDR6に及びませんが、64GB・128GBという容量は魅力的です。
④ 量子化と実行基盤の進化
MXFP4のような新しい量子化形式は、20Bを13GBに圧縮しつつ品質を保っています。実行基盤側(Ollama/llama.cpp)の最適化も日進月歩で、同じVRAMで載せられるモデルは今後も増えていくはずです。
まとめ:ローカルAIのPCは「VRAM何GBか」で選ぶ
8GB
7〜8Bクラスまでを最速で回す入門機。チャットや要約、定型文の作成なら十分。9B以上は載らないと割り切る。
12GB
9〜14Bクラスまで余裕をもって載る中位機。日本語品質の高いモデルを選べる。20Bは溢れるので、CPUが非力だと逆に遅くなる点に注意。
16GB
20Bクラスを全載せできる現実的な上限。提案資料の作成やツール呼び出しなど「賢さが要る」業務用途はここから。MoE型の30Bも視野に入る。
GPUを選ぶとき、つい「世代」や「型番の数字」に目が行きがちです。しかしローカルAIに限っては、まず「動かしたいモデルのサイズ」を決め、それが丸ごと収まるVRAMを積む──この順番で考えるのが、いちばん失敗しない選び方だと思います。
弊社では、こうした検証結果をもとに「業務データを外に出さないローカルAI環境」の構築や、モデル選定のご相談を承っています。お気軽にお問い合わせください。
参考・出典
- NVIDIA「GeForce RTX 4060 ファミリー 仕様」 https://www.nvidia.com/ja-jp/geforce/graphics-cards/40-series/rtx-4060-4060ti/
- NVIDIA「GeForce RTX 2060 仕様」 https://www.nvidia.com/ja-jp/geforce/graphics-cards/rtx-2060/
- AMD「Radeon RX 9060 XT 製品仕様」 https://www.amd.com/ja/products/graphics/desktops/radeon/9000-series/amd-radeon-rx-9060-xt.html
- Ollama https://ollama.com/ / モデルサイズは各モデルのライブラリページ掲載値(標準量子化)
- RTX 4060 Ti 画像: 极客湾Geekerwan「RTX4060TI评测:只比3060TI快10%」(YouTube, CC BY 3.0)Wikimedia Commons https://commons.wikimedia.org/wiki/File:RTX4060TI%E8%AF%84%E6%B5%8B%EF%BC%9A%E5%8F%AA%E6%AF%943060TI%E5%BF%AB10%25_(%E6%9E%81%E5%AE%A2%E6%B9%BEGeekerwan)_06.png
- RTX 2060 画像: Mr ATM, CC BY 2.0, Wikimedia Commons https://commons.wikimedia.org/wiki/File:NVIDIA_GeForce_RTX_2060.jpg
- RX 9060 XT 画像: Padgriffin, CC BY 4.0, Wikimedia Commons https://commons.wikimedia.org/wiki/File:AMD_Radeon_RX9060XT.png
- 計測値はすべて弊社の実測(2026年6〜9月)。モデルの回答品質は同一設問セットをAIで採点した相対値であり、絶対的な性能を保証するものではありません。