— Blog
VRAMからはみ出したAIは、頭が悪くなるのか? 実測と計算式で確かめた
目次
ローカルAI(PCの中だけで動かすAI)を検討していると、必ず出てくる疑問があります。「うちのPCでは力不足なモデルを無理やり動かしたら、答えの質まで落ちるのでは?」──前回の記事で「速さはVRAMで決まる」と書きましたが、今回はその続きとして、頭の良さは変わるのかと、どのくらい遅くなるかを計算で予測できるかを実測で確かめました。
この記事の結論(3行)
- 性能の低いPCで大きなモデルを動かしても、同じモデルなら答えの中身は変わらない。ただし言い回しが少し変わることはある。
- 遅くなり方は「VRAMからはみ出した量 ÷ メモリの速さ」でほぼ計算できる。実測前に立てた予測(約1.7 tok/s)に対し、実測は1.67〜1.72 tok/sだった。
- VRAMの2倍のサイズのモデルは1秒に約3文字。答えの質は変わらなくても、対話で使うには遅すぎた。
疑問:PCの力不足は「頭の悪さ」になるのか
ローカルAIのモデルは、GPUのメモリ(VRAM)に丸ごと載せて動かすのが基本です。VRAMに入りきらない大きなモデルでも、Ollama などの実行環境は、はみ出した分をPC本体のメモリ(RAM)に置き、CPUに計算させて動かしてくれます。
このとき起きるのは「遅くなる」ことだけなのか、それとも「答えが雑になる」ことまで起きるのか。直感的には、無理をさせたら品質も落ちそうに思えます。そこで、同じモデルを使い、GPUに載せる量だけを変えて答えを比べてみました。
検証に使ったPCとモデル
| 項目 | 内容 |
|---|---|
| GPU | AMD Radeon RX 9060 XT(VRAM 16GB・理論帯域 320GB/s) |
| CPU / メモリ | Core i7-7700(4コア)/ DDR4-2400 デュアルチャネル 32GB(理論帯域 38.4GB/s) |
| 実行環境 | Ollama 0.34.2(ROCm)。APIを直接叩いて計測値を取得 |
| モデルA | gemma3:27b(Q4_K_M・約18GB)……VRAMの約1.15倍 |
| モデルB | gemma3:27b-it-q8_0(約30GB)……VRAMの約2倍 |
| 条件 | temperature 0(ランダム性なし)/ seed固定 / 最大300トークン / 同じ6問 |
前回の記事の「3号機」と同じPCです(その後、本体メモリを32GBに増やしています)。モデルAとBは同じ gemma3 27B で、違いは圧縮の度合い(量子化)だけです。Aは4bit前後に圧縮した軽い版、Bは8bitの重い版です。
質問は、会社設立の手続き、途中式つきの計算、お詫びメールの作成、用語の説明、文章の要約、契約書の読み取りの6種類です。モデルAは、GPUに載せる「段」の数を、自動(53段)→ 40段 → 20段 → 0段(CPUのみ)と減らしながら同じ質問をしました。
「段」とは何か(2026年9月30日 追記)
公開後に「段がわからない」とご意見をいただいたので、補足します。
AIのモデルの中身は、同じ形の計算を63回くり返す「63段の計算の列」になっています。質問を受け取ると、1段目から63段目まで順番に全部通して、ようやく答えの1トークン(1〜2文字)が決まります。次の1トークンを出すときも、また1段目から63段目まで全部通します。これを答えが終わるまでくり返します。
段ごとに「重み」と呼ばれる大量の数値が付いていて、計算のたびにそれを読み出します。この63段分の重みを、速いGPU(VRAM)に何段置き、残りを遅いCPU(本体メモリ)に何段置くかを指定できます。これが「GPUに載せる段数」です。
たとえるなら、63人が並んだバケツリレーです。GPUに置いた段は手の速い人、CPUに置いた段は手の遅い人です。答えの中身(バケツの中身)は誰が運んでも変わりませんが、遅い人が増えるほど1杯運ぶのに時間がかかります。「自動(53段)」は、VRAMに入るだけGPUに置いて、入りきらない10段をCPUに回した状態です。
結果①:中身は同じ。言い回しだけが変わることがある
まず、同じ設定で2回実行すると、5問中5問で一字一句同じ答えが返ってきました。ランダム性をなくしているので、ここまでは想定どおりです。
一方、GPUに載せる段数を変えると、言い回しが変わる問題が出ました。
| 質問 | 自動(53段) | 40段 | 20段 | CPUのみ |
|---|---|---|---|---|
| 定款認証の必要書類 | 基準 | 言い回し違い | 言い回し違い | 言い回し違い |
| 原価の計算 | 基準 | 言い回し違い | 完全一致 | ― |
| お詫びメール | 基準 | 言い回し違い | 完全一致 | ― |
| RAMとVRAMの説明 | 基準 | 言い回し違い | 言い回し違い | 言い回し違い |
| 営業時間の要約 | 基準 | 完全一致 | 完全一致 | 言い回し違い |
| 答えの中身 | すべての構成で同じ(計算結果・挙げた書類・結論) | |||
違いは、たとえば次のような程度です(RAMとVRAMの説明の3文目)。
自動(53段)
RAMが多いほど、たくさんの情報を素早く処理でき、VRAMが多いほど、より高画質な映像をスムーズに表示できます。
CPUのみ
RAMが多いほど、たくさんのソフトを同時に快適に動かせますが、VRAMが多いほど、より美しい映像をスムーズに表示できます。
計算問題はどの構成でも「1個あたり1,348円」と正解し、途中式も同じでした。お詫びメールも、謝罪・遅れた理由・再発防止・見積書の添付という構成はすべて同じです。ただし40段の回だけ、メールに「いたしまししたが」という1文字の誤字が混ざりました。入れ替わりがたまたま悪い方に転ぶこともある、という例です。
なぜ言い回しが変わるのか。AIは「次に来る言葉の候補」に点数をつけ、いちばん点の高いものを選んで文章を作ります。GPUとCPUでは計算の順番が違うため、点数の小数点以下のずっと先に、ごく小さな誤差が出ます。ほとんどの場面では1位は動きませんが、1位と2位がほぼ同点のところでは入れ替わることがあります。一度違う言葉を選ぶと、その後の文章も少しずつ変わっていきます。つまり、頭の良さが落ちたのではなく、同じくらい良い別の言い方を選んだということです。
間違いも「同じように」出る
おもしろかったのは、間違いまで同じだったことです。定款認証の必要書類を聞いた質問では、どの構成でも「発起人の戸籍謄本」を挙げました。定款認証では通常、戸籍謄本は求められません。この誤りはGPUに全部近く載せても、CPUだけで動かしても、8bitの重い版(モデルB)でも同じように出ました。
つまり、答えの正しさを決めているのはPCではなくモデルが覚えている知識です。PCを高性能にしても、この間違いは直りません。
では、何が精度を下げるのか
精度に影響するのは、PCの性能ではなくモデルの圧縮の度合い(量子化)です。小さいPCに載せるために強く圧縮した版を選ぶと、そのぶん知識や判断が粗くなることがあります。一般には、4bitくらいまでなら差は小さく、それより強く圧縮すると差が目立ってくると言われています。
今回の6問では、4bit版(A)と8bit版(B)で答えの中身に目立った差は出ませんでした。計算は両方正解、誤りは両方同じでした。問題数が少ないので「差がない」とまでは言えませんが、少なくとも「VRAMに載らないから8bit版は諦めて4bit版にする」ことの損は、思ったより小さいというのが今回の手応えです。
結果②:遅くなり方は計算できる
答えの中身が変わらないなら、残る問題は速度です。こちらは段数によって大きく変わりました。
| 構成 | VRAMに置いた量 | RAMに置いた量 | 生成速度 | 1秒あたりの文字数(目安) |
|---|---|---|---|---|
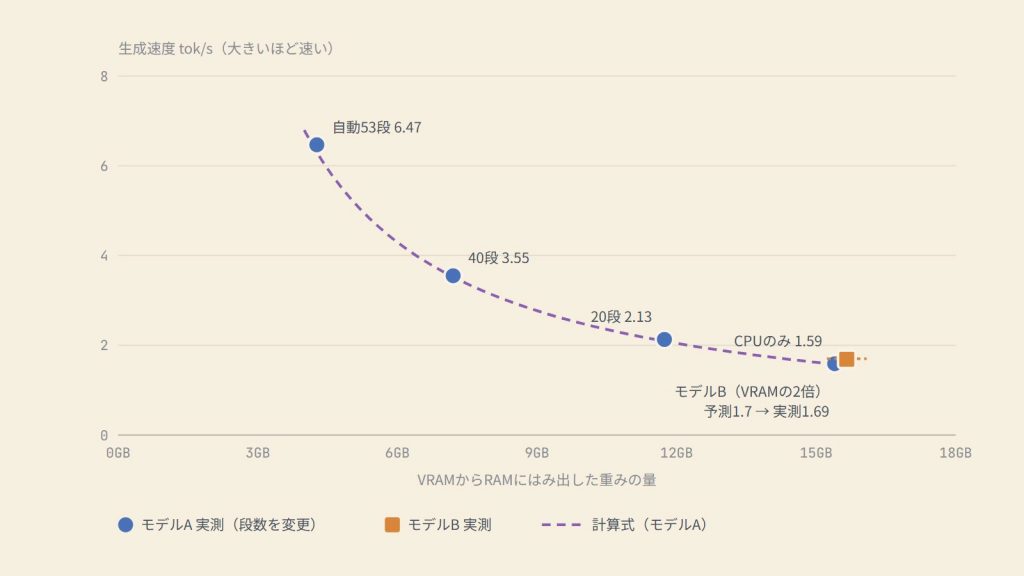
| A:自動(53段) | 13.0GB | 4.3GB | 6.3〜6.7 tok/s | 約12字 |
| A:40段 | 10.0GB | 7.2GB | 3.55 tok/s | 約6字 |
| A:20段 | 5.5GB | 11.7GB | 2.13 tok/s | 約4字 |
| A:CPUのみ | 0GB | 15.4GB | 1.59 tok/s | 約3字 |
| B:自動(30段) | 13.2GB | 15.7GB | 1.67〜1.72 tok/s | 約3字 |
(tok/s は1秒あたりに生成するトークン数。このモデルの日本語では、1トークンがおよそ1.8文字でした。)
速度を決める計算式
AIが文章を1トークン出すたびに、モデルの重み(学習済みの数値)をメモリからほぼ全部読み出します。この処理は計算の速さより「読み出す速さ」で決まります。VRAMは速く、RAMは遅い。したがって1トークンにかかる時間は、次の式で表せます。
生成速度(tok/s)= 1 ÷ 1トークンの時間
BVRAM:GPU側の実効的な読み出し速度 BRAM:CPU+本体メモリ側の実効的な読み出し速度
E:RAMに置かれても毎回は読まない部分(このモデルでは画像を読むための部品など)
このPCの係数は、実測から次のように求めました。
| 係数 | 値 | 求め方 |
|---|---|---|
| BVRAM | 約220GB/s | VRAMに丸ごと載る7B・9Bのモデルで実測(理論値320GB/sの約70%) |
| BRAM | 約21GB/s | モデルAの4構成から逆算(理論値38.4GB/sの約55%) |
| E | 約2.2GB | 同上 |
VRAMの読み出しは、RAMの約10倍の速さです。つまり、VRAMからはみ出した1GBは、VRAMの中の1GBの約10倍の時間がかかります。はみ出しが数GBを超えると、速度はほぼ「RAMの速さ ÷ はみ出した量」だけで決まります。GPUがどれだけ速くても、はみ出した瞬間にPC本体のメモリの速さの勝負になります。
モデルAの4構成では、式による計算と実測がいずれも3%以内で一致しました。
実測する前に予測してみた
式が本当に使えるかを確かめるため、モデルB(VRAMの約2倍)を測る前に、予測値を記録しておきました。
| 生成速度 | |
|---|---|
| 実測前の予測 | 約1.7 tok/s |
| 実測 | 1.67〜1.72 tok/s |
結果はほぼ的中しました。ただし正直に書くと、予測の段階ではGPUとRAMへの振り分けを読み違えていました。実際にはRAM側に2GBほど多く置かれており、その実際の振り分けで計算し直すと1.47 tok/s(実測より約12%低い)になります。
差が出た理由は、4bit版は圧縮を解く計算が重く、4コアのCPUでは読み出しに加えて計算も足を引っ張っていたためと考えています。8bit版は解く計算が軽いので、RAM側の実効速度が約25GB/sまで上がりました。予測がぴったり当たったのは、この2つの誤差が打ち消し合った面もあります。それでも、±15%程度の精度で「何秒かかるか」を事前に見積もれる、というのが今回の結論です。
実用になるのか:VRAMの2倍は「待てない」遅さ
最後に、実際の作業でどれだけ待つことになるかを比べました。
モデルB(VRAMの2倍)は、200トークンほどの回答に2分、300トークンの回答に3分かかりました。1秒に約3文字は、人が文章を読む速さの3分の1ほどです。画面の文字がゆっくり出てくるのを待ち続けることになり、対話で使うのは現実的ではありません。
モデルA(VRAMの約1.15倍)は、1秒に約12文字。前回の記事で「待たされない目安」とした15〜20 tok/sには届きませんが、短いやり取りなら30秒前後で返ってきます。「少し待てば使える」ぎりぎりの線です。
なお、資料を読ませる速さ(読み込み)はモデルAで約290 tok/s、モデルBで約100 tok/sでした。契約書1,200トークンほどを読ませて要約させる作業は、Aで13秒、Bで46秒です。長い資料を読ませる用途では、答えを書く速さだけでなく、この読み込みの待ち時間も効いてきます。
まとめ:精度は落ちない。だからこそ「載るサイズ」で選ぶ
- 性能の低いPCで大きなモデルを動かしても、答えの中身は変わりません。言い回しが少し変わるのは、ほぼ同点の候補が入れ替わるためです。
- 答えの正しさを決めるのはモデルの知識と圧縮の度合いで、PCではありません。
- 遅くなり方は、はみ出した量とメモリの速さから計算で見積もれます。
- VRAMの2倍のモデルは、答えは良くても遅すぎて実用になりませんでした。
ローカルAIのPCを選ぶときは、「大きいモデルでも一応は動く」ことに安心せず、使いたいモデルがVRAMに収まるか、はみ出すならどれだけ待つことになるかを先に計算しておくのがおすすめです。今回の式を使えば、PCを買う前にある程度の見当がつけられます。
次回は、この式を使って「このPCで最高クラスのローカルAIを動かしたら、1回の回答に何分かかるのか」を予測してみる予定です。
弊社では、こうした検証結果をもとに「業務データを外に出さないローカルAI環境」の構築や、モデル選定のご相談を承っています。お気軽にお問い合わせください。
続編:「遅いなら、どこまでなら使えるのか」を、実際の開発・改修案件のAIとのやり取りの量から計算し、ボタンを押して速度を体感できる形にしました。
ローカルAIの「遅さ」はどこまで許せるか? チャットをやめて自動化すれば見えてくる答え
参考・出典
- 前回の記事: ローカルAIのPC選び、決め手は「世代」より「VRAM」だった https://syushi.com/blog/local-llm-gpu-vram-benchmark/
- Ollama https://ollama.com/ / gemma3 https://ollama.com/library/gemma3
- AMD「Radeon RX 9060 XT 製品仕様」 https://www.amd.com/ja/products/graphics/desktops/radeon/9000-series/amd-radeon-rx-9060-xt.html
- 計測値はすべて弊社の実測(2026年9月28日)。同一PC・同一モデル・temperature 0・seed固定。質問数が少ないため、回答品質の比較は傾向を示すものです。